 产品与服务
定制模型训练
用你自己的数据训练模型,用你自己的真实案例检验,而不是看公开榜单。
怎么做到的
先把数据洗干净
你的业务记录和文档,整理成一份干净的训练数据。
该标注的标注
给样本打上标签,模型才知道它们是什么。
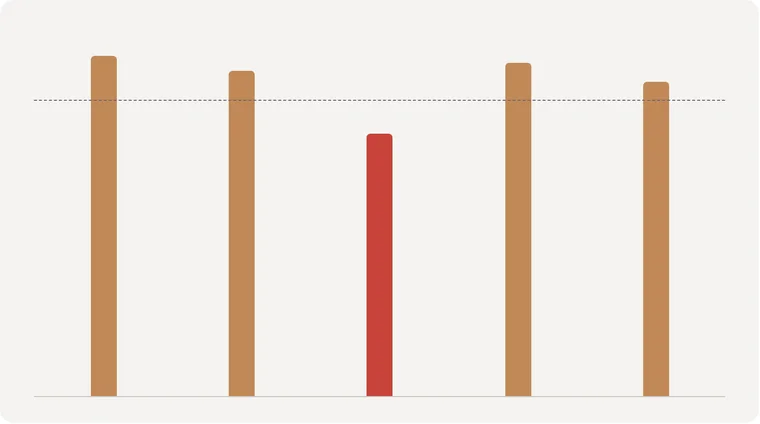
在你的案例上的得分合格线 80%
ABCDE
用你的真实案例检验
用你挑选的案例来评判模型,而不是看公开榜单。
仅作示意,名称和数字均为虚构。
查看完整说明
用通用数据训练出来的模型,常常抓不住你业务里真正关键的东西。我们从你的业务记录和文档开始。先清洗数据,再给需要的部分做标注,也就是给样本贴上标签。然后训练模型。最后用你挑的真实案例来检验。
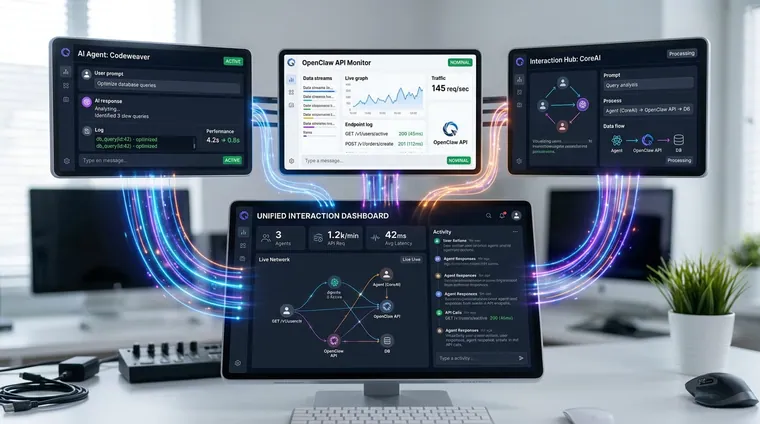
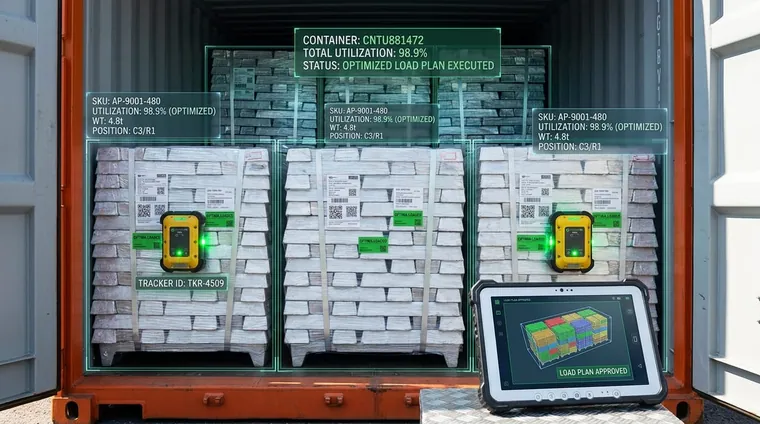
我们更愿意用能解决问题的最简单办法。很多时候,一个现成的 AI 模型加上你的数据就够了,不用从头训练。比如我们自己的素材质检工具,用的就是现成的视觉模型。只有在这些模型做不好的地方,才计划加一个小的训练模块。我们的数据分析引擎让数据库负责计算。语言模型只负责解释结果,所以每个数字都能核对。
上线以后,我们会一直监控模型表现。这样你就清楚什么时候该重新训练。
包含什么
数据来源与使用权
弄清楚你有哪些数据、来自哪里,能不能用来训练。
清洗与标注
去掉重复和错误,再标注模型需要学习的样本。
训练与微调
根据数据情况,训练新模型,或在现有模型上微调。微调就是在已有模型的基础上再训练。
用真实案例检验
用你挑选的案例来衡量模型,结果才能反映实际工作。
部署与监控
把模型投入使用,并一直跟踪表现。
方案优势
先把数据做好
我们本身也做数据清洗管线,也就是一整套清洗数据的步骤。训练开始前,数据集就已经整理好。
不为训练而训练
如果现成模型已经能解决问题,我们会直说,并直接用它。
结果可核对
涉及数字的地方,计算交给代码或数据库,不交给语言模型。
从一个小试点开始。
告诉我们要解决的事,我们先判断值不值得做。