研究做了什么,发现了什么
这是一篇预印本论文,标题是《枯燥、肮脏、危险?》(Dull, Dirty, Dangerous?),作者是普渡大学丹尼尔斯商学院的 Siyi Yu,2026年11月4日发布于 arXiv(2611.06888)。我们还没核实它的同行评审状态。它是一项观察性研究:用已有的公开数据,在不同职业之间找规律,没有新增访谈或实地观察。作者说得很直白:这两个指标都没有观察到AI的实际部署或者失业。
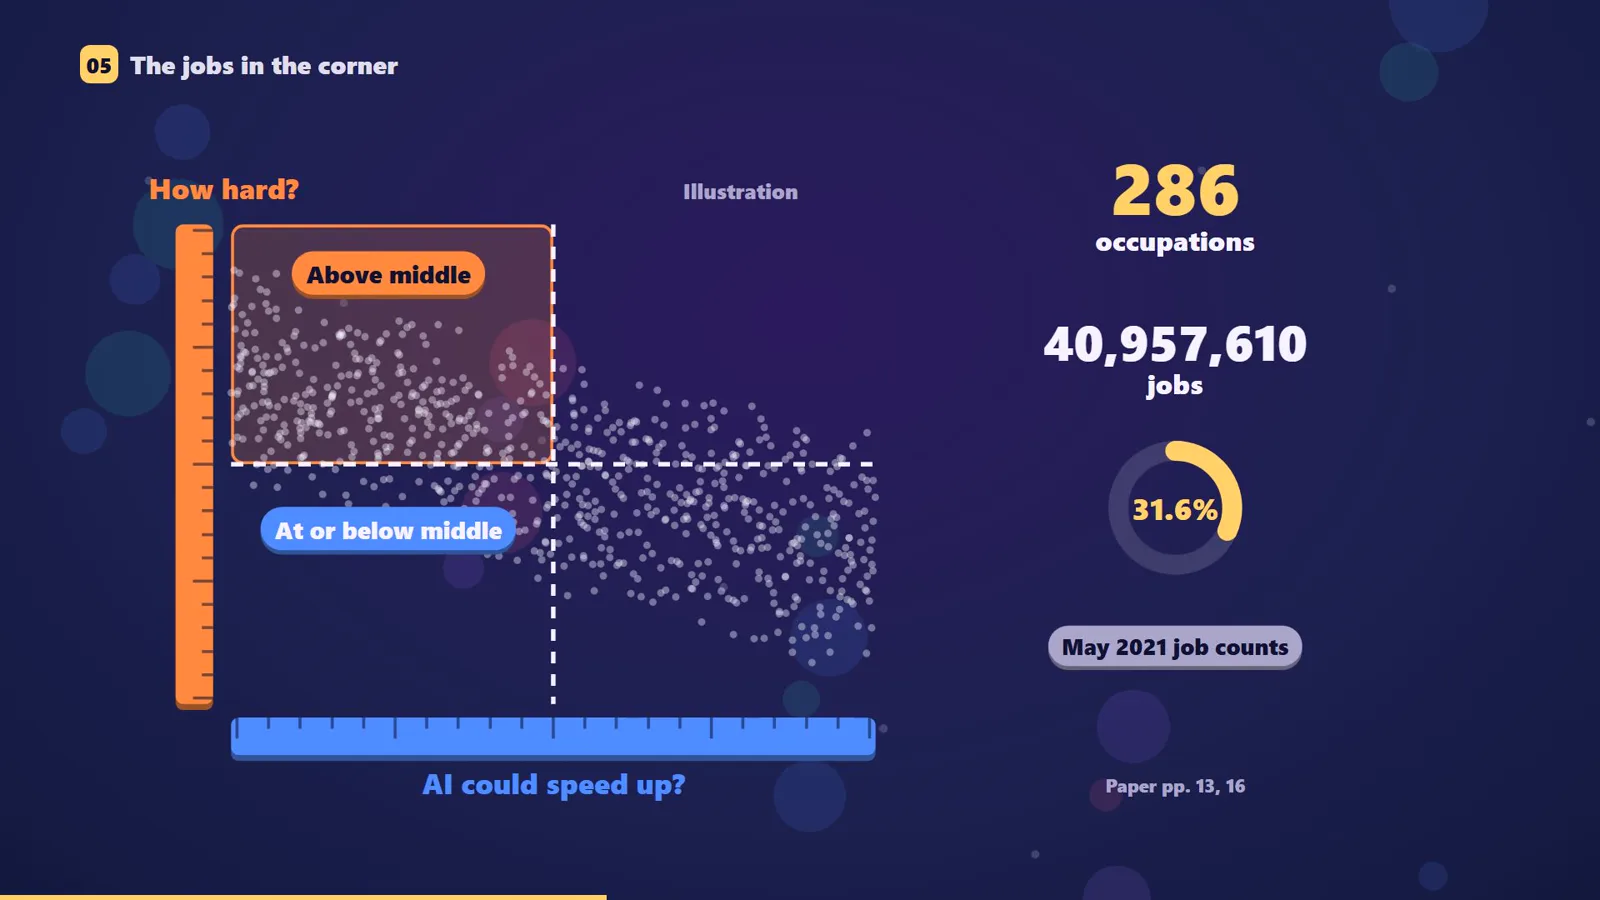
可以想象两把尺子。第一把量工作条件有多辛苦,用的是美国政府职业数据库 O*NET 第31.0版里的21项评分,分成危险、肮脏、枯燥三组。第二把量AI语言模型能帮这份工作提速多少,用的是两套已发表的评分:Eloundou 等人请人和GPT-4给任务打的分,以及 Felten 等人2021年的一套更早的评分。“暴露度”只是对潜力的评分,不代表已经在用。研究覆盖754种职业,占美国政府2021年5月就业统计里92%的工作。
规律是:AI尺子上越高的工作,辛苦尺子上往往越低,每高一格,大约低三分之一格。但把每份工作有多耗体力考虑进去以后,关联明显减弱(从负0.343降到负0.093)。在最完整的模型里,再加上学历、上岗准备和工资,语言模型评分的可能取值范围包含零;更早那套评分仍在零以下。AI暴露度对职业差别的额外解释只占很小一点(1.1%和2.4%)。作者强调,这只是描述规律,不说明因果。
辛苦、两套AI评分又都不高的这个角落,有286种职业、将近四千一百万个工作岗位,占研究全部工作的31.6%,包括建筑工人、重型卡车司机、护理助理、餐馆厨师、园林工人和客房清洁工。这个数字数的是2021年5月数据里的岗位,不是想要帮助的人数,也不是面临风险的人数。而且辛苦各不相同:建筑工人自己的三项得分里“肮脏”最高(2.07),客房清洁工则是“枯燥”最高(1.18)。
证据有多硬
我们通读了论文,并顺着引用追到原始数据。研究对来源的描述是准确的。主要的AI评分规定:语言模型能把任务时间缩短至少一半、质量不变,才算“暴露”;评分者还被告知模型没有任何实物工具或材料。那项研究自己也说,至少目前体力劳动不会暴露于语言模型。所以体力活在这把尺子上得分低,有一部分是尺子本身决定的。
- 两套AI评分用的是同一个职业数据库,相关高达0.833,不是两个互相独立的证人。
- 更早那套评分,我们只能打开主要论文的摘要,打不开下面的众包调查。
- “枯燥、肮脏、危险”这句口号,我们没能追溯到任何针对工人的研究。研究引用的一篇2026年机器人综述发现,用这句话的论文里只有25篇(2.7%)给了正式定义。
- “枯燥”指对重复和自主程度的评分,不是无聊的感觉。“自己说了不算”和AI评分的关联比“重复”强得多,但这个差别没有做正式检验。
我们的结论:扎实,但在意料之中。
我们的小实验
我们下载了 O*NET 31.0(2026年8月)和已公开的暴露度评分,运行前先写下要测什么、预期什么(这是我们自己的记录,不是外部登记),用21项评分里的9项做了一个更简单的辛苦指标。在772种职业上,关联是负0.70;在同一职业大类里比较是负0.36,研究是负0.343。加入体力因素后,我们的降到负0.15,少了一半以上,与预期一致,但没有像研究的负0.093那样接近零。我们的指标更简单,也没加学历和工资,两者不能直接比较。第一次运行时代码在出数字前就崩了,已经修好。
数据科学家在AI尺子上高于95%的职业,在辛苦尺子上只高于9%;软件开发人员是98和5;建筑工人正好相反,辛苦94、AI 12。我们的角落里,772种职业中有305种(39.5%)辛苦又低暴露,但这数的是职业种类,不是人数,和31.6%不是同一种数字。
可以怎么用
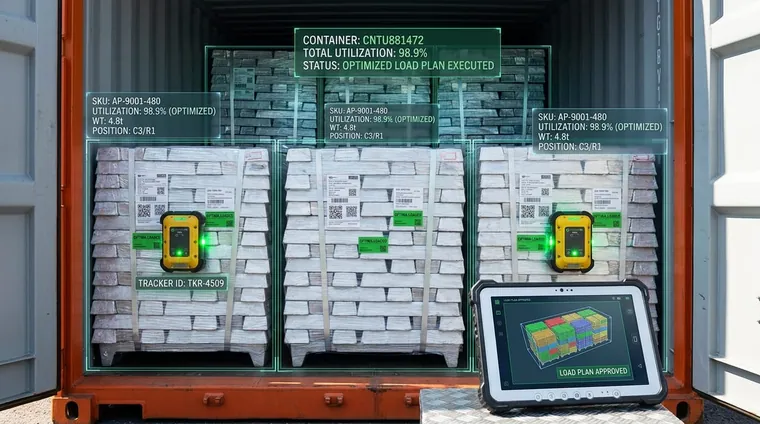
语言模型分数低,不是护身符。在我们的一个项目里,仓库装卸区上方的摄像头把每一步和标准流程对照,对不上就打时间戳;只看动作、不认人,没有人脸识别。手工搬运工在AI尺子上接近零,AI还是来到了他们的工作里。研究也提醒:分数低不能说明不受别的自动化或管理工人的软件影响。
有人推荐“让工作更安全的AI”时,先问三个问题:它改变哪项任务?哪种条件会变好,搬重物、噪音还是节奏?工作又流向哪里?再和调整人手、换更安全的设备这类朴素办法比一比。对自己的工作,可以写下十项主要任务,逐一标记:语言模型能提速吗?是体力活吗?是不是风险高、出不得错?