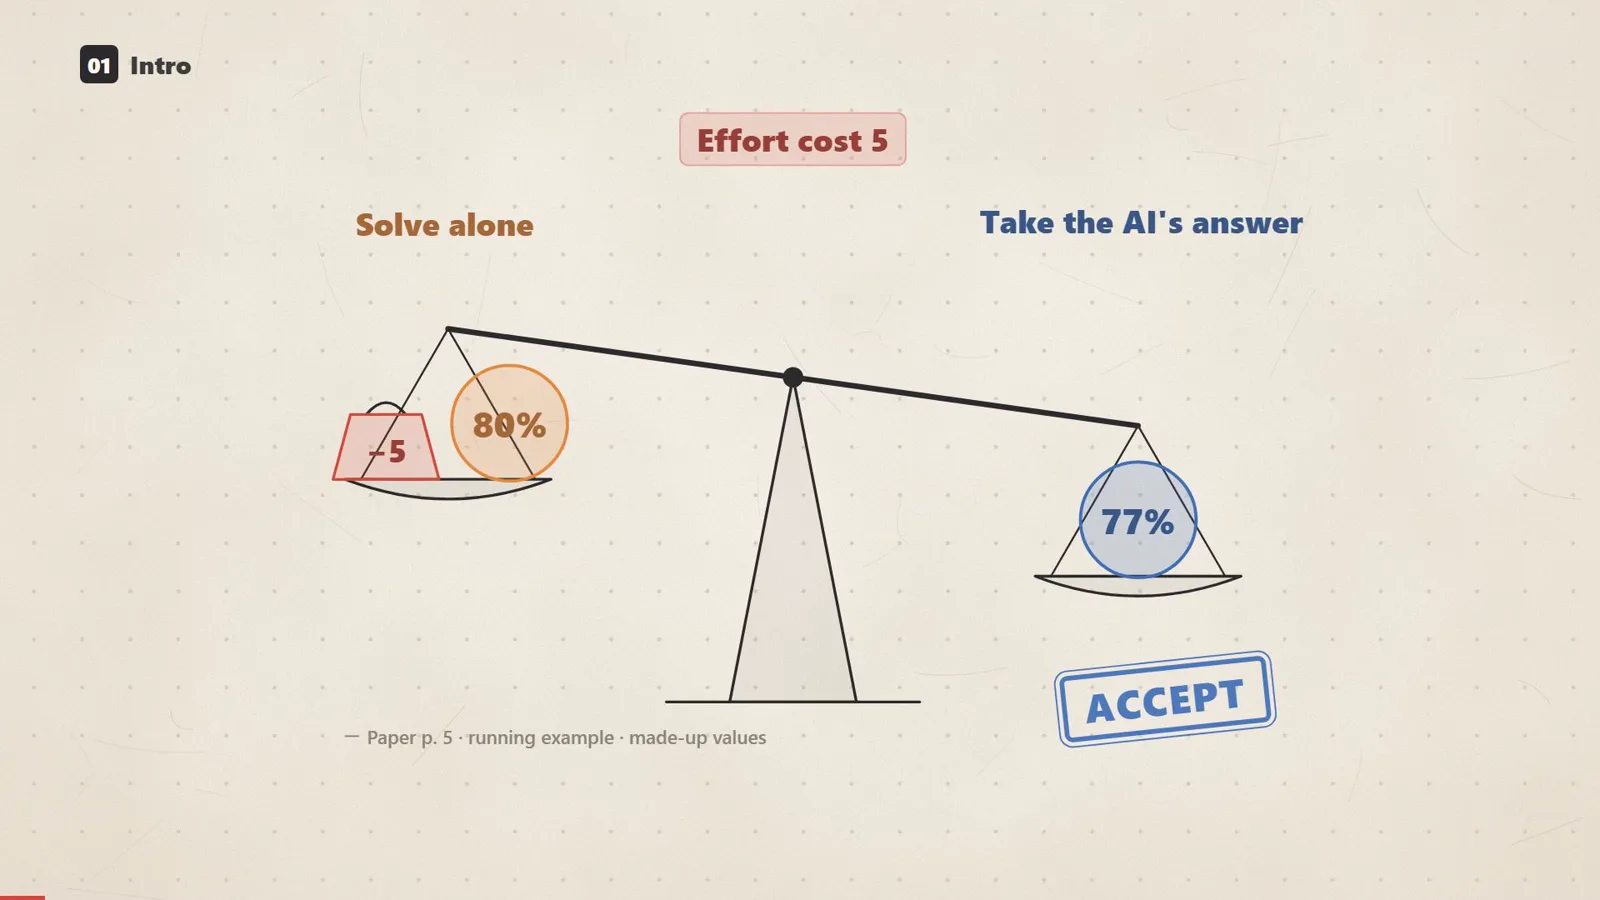
一项新研究提了一个很实在的问题:用了AI,你会不会少了练习?论文开头举了一个例子:一位专家负责检查代码里的错误,她自己检查能找到八成,她的AI助手能找到百分之七十七。她比AI略强,但自己检查要花力气,把这份代价算进去,每一次都是直接用AI的答案更划算。于是她一次又一次地接受AI的答案。结果一直是百分之七十七,看起来不错,可她不靠AI时的本事在慢慢退化,从结果里谁也看不出来。这些数字是编的,来自论文自己的例子;这是模型,不是对真实员工的测量。
这项研究是什么,得出了什么
论文题为 Today's Work, Tomorrow's Workforce: Incentivizing Learning in AI-Assisted Work,作者是 Diener、Hendriks、Spitzer、Satzger、Holstein(德国卡尔斯鲁厄理工学院)和 Sun(IBM Research),2026年11月4日发布在 arXiv(2611.06346)。这是预印本,我们还没核实它的同行评审状态。它是一个数学模型:一个员工,一长串类似的任务,引用了两项早先的研究。每个任务,员工要么接受AI的答案,要么自己解;自己解要花力气,但本事可能涨一级,接受能省力气,但本事可能掉一级。作者自己说,例子里用的是示意数值,“不是实证估计”。
论文区分了“产出准确率”(在AI帮助下的结果)和“独立准确率”(自己做有多大比例做对),并指出大多数相关研究测的是前者。在模型里:
- 如果练习现在和将来的好处抵不过它花的力气,练习就可能停下来,哪怕这个人还比AI略准。
- 面对百分之六十二的AI,一个百分之四十的新手会一直接受,卡在最低一级,这叫“低技能陷阱”;专家则可能退化,叫“专家技能退化”。产出始终停在AI的水平。
- 一种只比今天任务准确率的常见打分方式,会说那个被卡住的新手对AI的依赖是恰当的。
- 给不靠AI做对的答案付钱,能让人重新开始练习。作者也说明,他们的例子说明不了这在真实工作里有多常见。
证据有多扎实
我们把论文的主要来源追查到了原处。“练习长本事”这条根很扎实:一项汇总86项研究的综述发现,人对自己想出来的东西记得更牢,但那是实验室和课堂里几分钟到一周的记忆,不是几个月里的工作本事。本事不练会退,1998年一项汇总53项研究的综述发现了这一点;但我们找到的来源里,没有一项测过每接受一次AI答案本事会掉多少,这部分是模型的假设。现实证据有两项:一项是52个程序员一小时的小试验,用AI的一组在满分27分的测验里,平均比不用AI的一组低4.15分,论文描述准确,但规模小,而且是预印本;另一项是波兰四家诊所的医生,不用AI的检查发现率从28.4%降到22.4%,论文说这是AI撤掉之后发生的,其实并没有撤掉,而且这是观察性研究,所以这条根被拉伸了。论文还漏提了部分同一批作者早先的一项实验:180人参与,给不靠AI答对的答案发固定奖金,结果被钻了空子,准确率略降(63.2%,没有奖金的组是64.3%),有针对性的奖金则略升到65.3%。结论:想法说得通,证据偏薄。
我们做的小实验
我们用代码重建了论文的模型,用的是论文例子里的数字:新手百分之四十、中级员工六十、专家八十,各做三百个任务,AI为百分之七十七。这是模拟,员工和概率都是编的;我们核对的七个数字与论文全部吻合。按论文的规则,三个人每次都接受AI,结果停在百分之七十七,但专家不靠AI的预期本事降到五十三左右,中级员工降到四十二左右,百分之九十五的模拟专家至少掉了一级。改成每隔一个任务由人先答(交出去的仍是AI的答案),结果仍是百分之七十七,新手涨到五十九左右,中级员工涨到六十九左右。意外的是,专家最后仍在七十四左右,百分之四十的模拟专家还是掉了一级;代价是多出一百五十次尝试。一次小测试的噪声也很大:若本事真从八十降到七十,二十题的测试约有百分之二十九的情况看不出下降。这是对想法的检查,不能证实这篇论文。
一条实用建议
把它当作设计原则,而不是测出来的事实。挑一个你每天交给AI的任务,其中一部分先自己做,再看AI的答案;每个月用过去的案例做一次不用AI的小盲测,记下分数,看几个月的趋势,别只看一次。管理者可以在产出准确率旁边同时跟踪独立准确率;如果要奖励练习,要设计得小心。这些是值得试的做法,不是已被证明有效的办法。